Inputs
480 observaciones mensuales raw: 8 compañías sintéticas durante 60 meses, más 12 eventos sintéticos publicables.
Caso de estudio
Producto de datos / Motor benchmark desde datos raw
Un dashboard benchmark raw para cuota, ranking, monetización, agregación y escenarios locales de forecast.
Un dashboard público de inteligencia benchmark que convierte cinco años de observaciones mensuales sintéticas de revenue y tráfico en análisis de cuota del set benchmark, rankings, diagnóstico de monetización, agregación por periodo y forecasts locales de escenario. El sistema empieza con 480 filas mensuales raw y genera en código la capa de inteligencia: filas benchmark, cuotas, rankings, métricas de eficiencia, crecimiento y escenarios de forecast.
Solo en modo demo: compañías sintéticas, valores sintéticos y etiquetas públicas; sin datos reales de compañías, clientes, logos ni fuentes privadas.
Resumen del caso
El problema, la respuesta del sistema, la prueba disponible, el valor estratégico y el límite intencional.
Contexto de negocio
El análisis competitivo suele vivir en hojas de cálculo, capturas y decks aislados. Las mismas preguntas se repiten: quién gana cuota, quién es más eficiente, qué players mejoran y qué podría pasar después.
Sistema / Solución
Un contrato source_monthly alimenta un pipeline canónico que valida observaciones raw, genera filas benchmark, calcula cuotas/rankings/eficiencia, crea escenarios locales de forecast y renderiza el resultado en un dashboard ejecutivo React/Vite.
480 observaciones mensuales raw: 8 compañías sintéticas durante 60 meses, más 12 eventos sintéticos publicables.
Validación, pipeline benchmark canónico, filas market_total y market_average generadas, forecast, modelos de vista y checks de publicación.
Cuota del set benchmark, rankings, crecimiento, métricas indexadas, revenue per visit, monetization gap, agregación y métricas derivadas del forecast se calculan en código.
Dashboard ejecutivo, Players/perfiles, Battle Arena, vista de forecast, rankings y estado de datos publicable.
Disciplina de datos sintéticos, cero datos reales de clientes o competidores y validación de publicación antes de desplegar.
Qué cambió
Reconstruí el proyecto en varios sprints: de JSON preparado para dashboard a observaciones raw en source_monthly, de filas benchmark estáticas a market_total y market_average generadas, de métricas precalculadas a cálculos runtime, y de rutas frágiles a Battle Arena y Players/perfiles funcionando.
El JSON público guarda solo observaciones mensuales raw. Los payloads legacy con data.interface siguen soportados por compatibilidad, pero ya no son la fuente preferente.
market_total y market_average se generan en runtime desde las filas observadas de compañías y se excluyen de denominadores de cuota y rankings cuando corresponde.
Cuota, rankings, crecimiento, métricas indexadas, revenue per visit, monetization gap, agregación anual y rangos se calculan en código.
Dashboard ejecutivo, Players/perfiles, rutas #/company/:id, rutas legacy #/empresa/:id, Battle Arena y Forecast funcionan desde filas canónicas generadas.
Arquitectura
La arquitectura final separa datos fuente e inteligencia benchmark. Revenue y visitas mensuales entran por data.source_monthly; el pipeline canónico valida filas, normaliza entidades, calcula métricas benchmark, genera filas sintéticas, crea forecasts, recalcula métricas derivadas y devuelve filas listas para el dashboard.
Cinco años de revenue y visitas mensuales sintéticas: de 2021-01-01 a 2025-12-01.
Acepta filas source_monthly y rechaza métricas benchmark derivadas en la capa raw.
Construye filas listas para dashboard desde observaciones raw y mantiene el JSON público pequeño, legible y seguro.
Calcula cuota del set benchmark, rankings, valores indexados, crecimiento, revenue per visit y monetization gap.
El default local_engine proyecta revenue y visitas y vuelve a pasar las filas forecast por el pipeline benchmark.
Renderiza overview de mercado, Players, Battle Arena, perfiles, escenarios de forecast y contexto de salud de datos.
Prueba visual
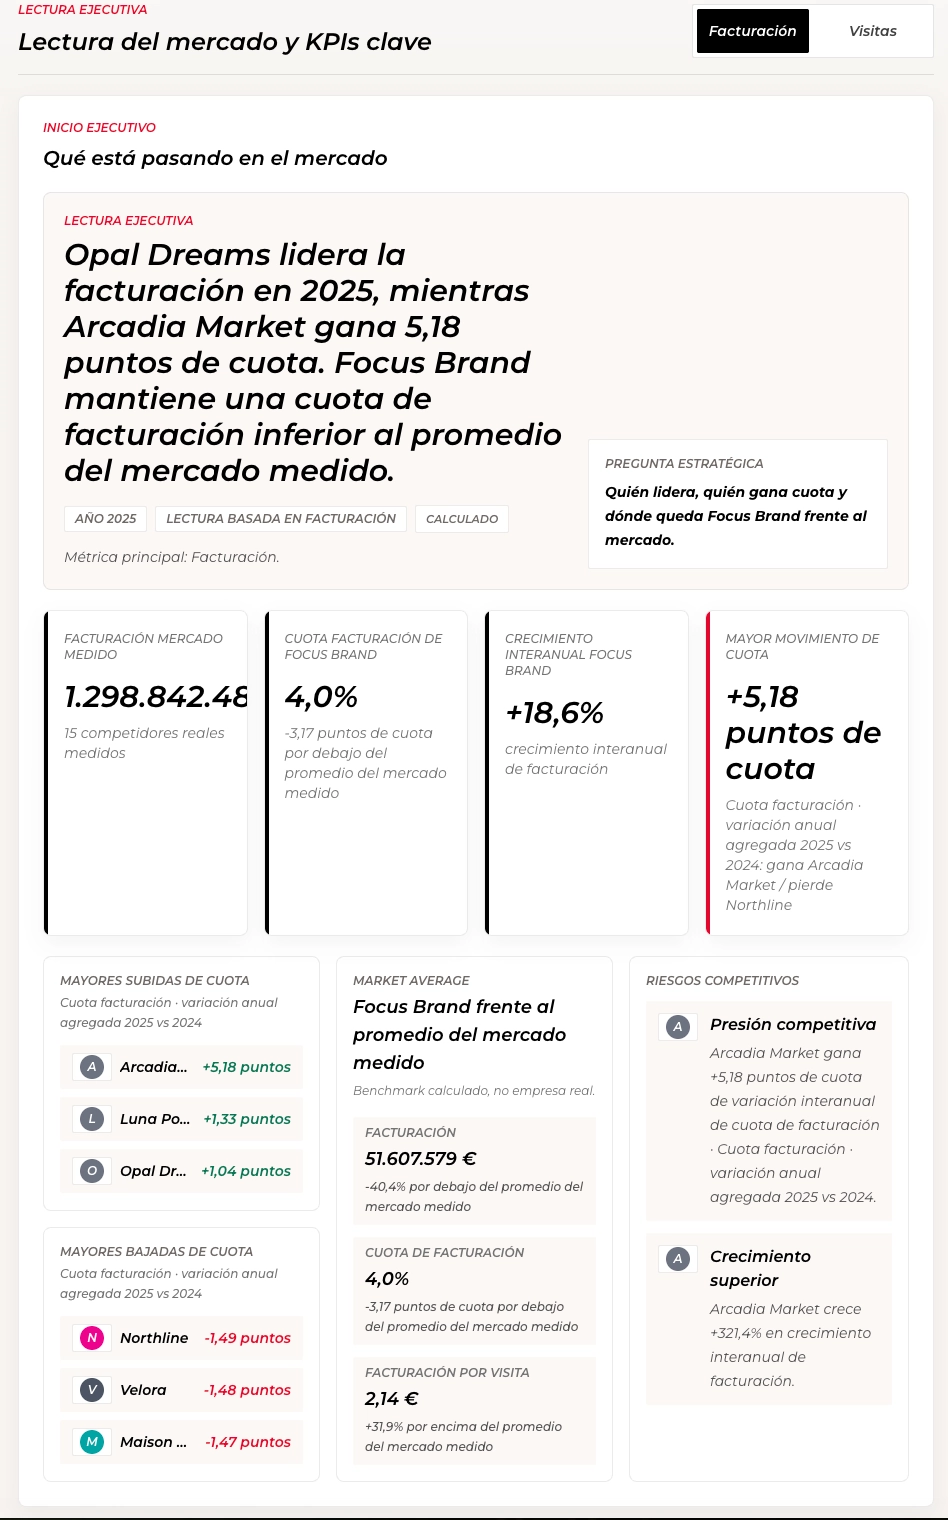
La interfaz publicada muestra la superficie de producto alrededor del pipeline: overview ejecutivo, rankings, movimiento de cuota, Players/perfiles, Battle Arena y escenarios de forecast generados desde el histórico de cinco años.
La interfaz se organiza en modos ejecutivos funcionales: overview de mercado, Players, Battle Arena y espacio de forecast.
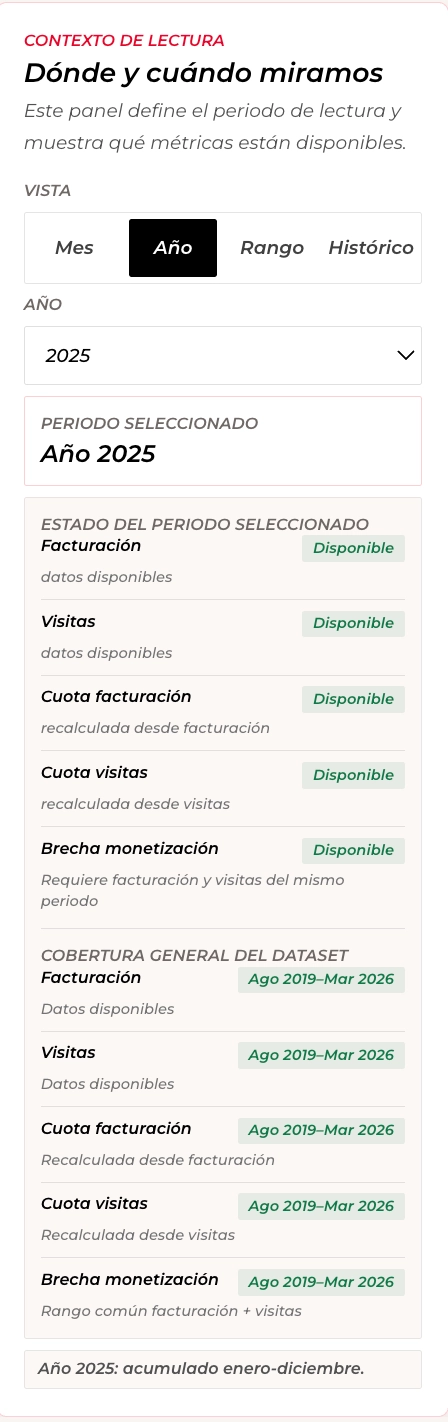
La agregación anual y por rango se calcula sumando revenue y visitas, y después recalculando las métricas benchmark del periodo.
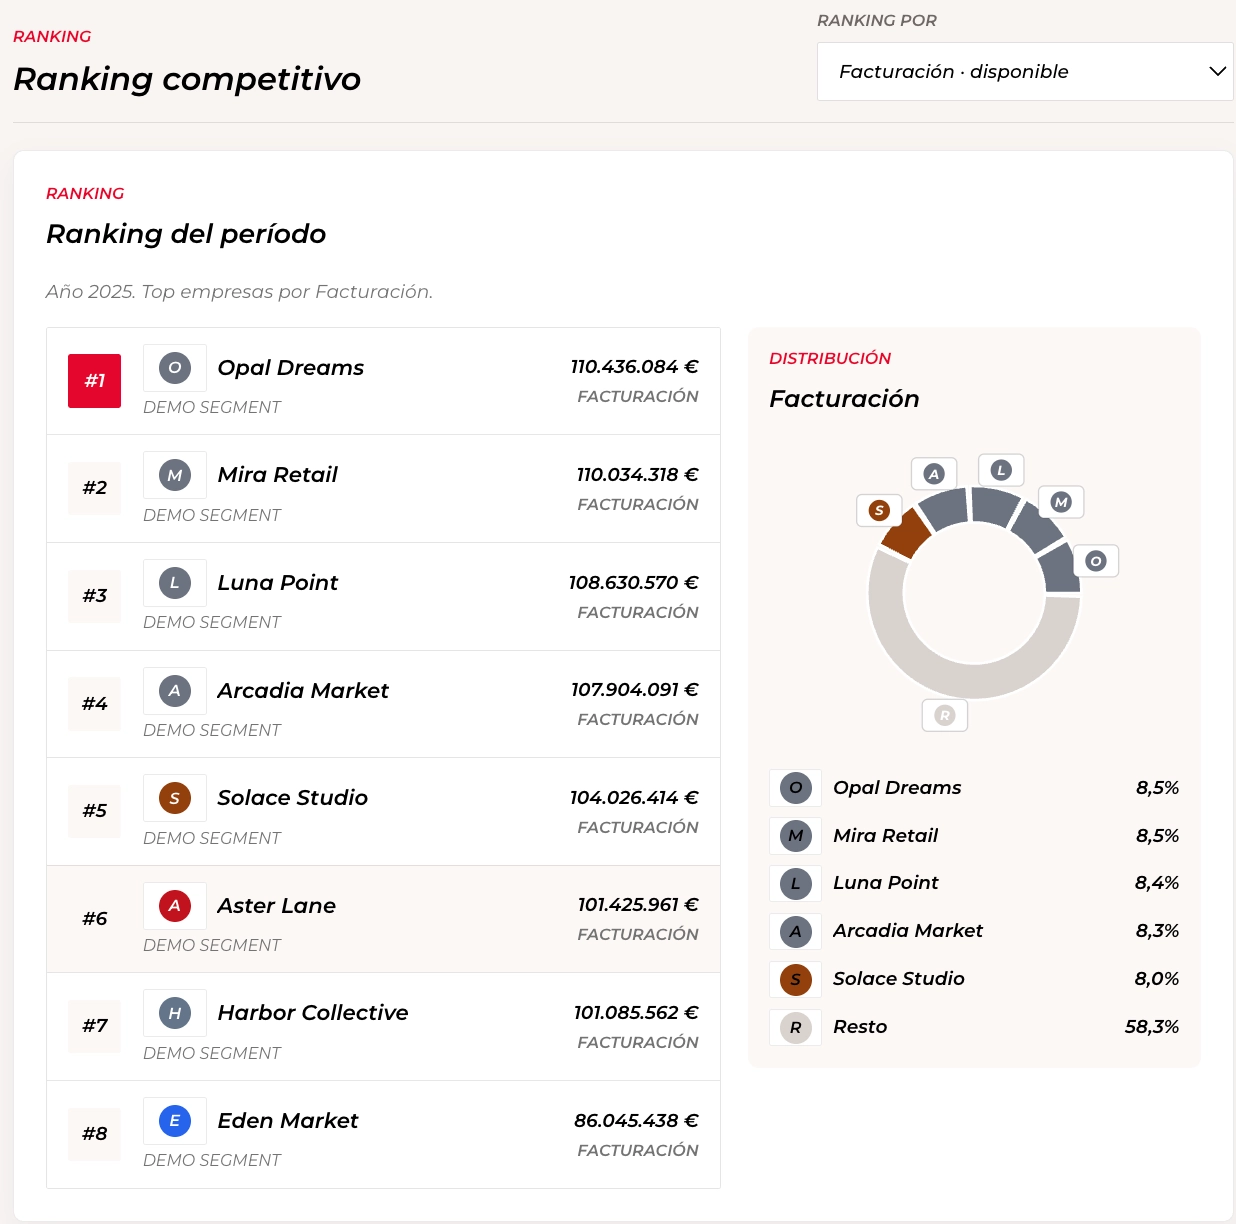
Ranking con cuotas y posiciones generadas para el set benchmark, útil para comparación ejecutiva sin datos reales de compañías.
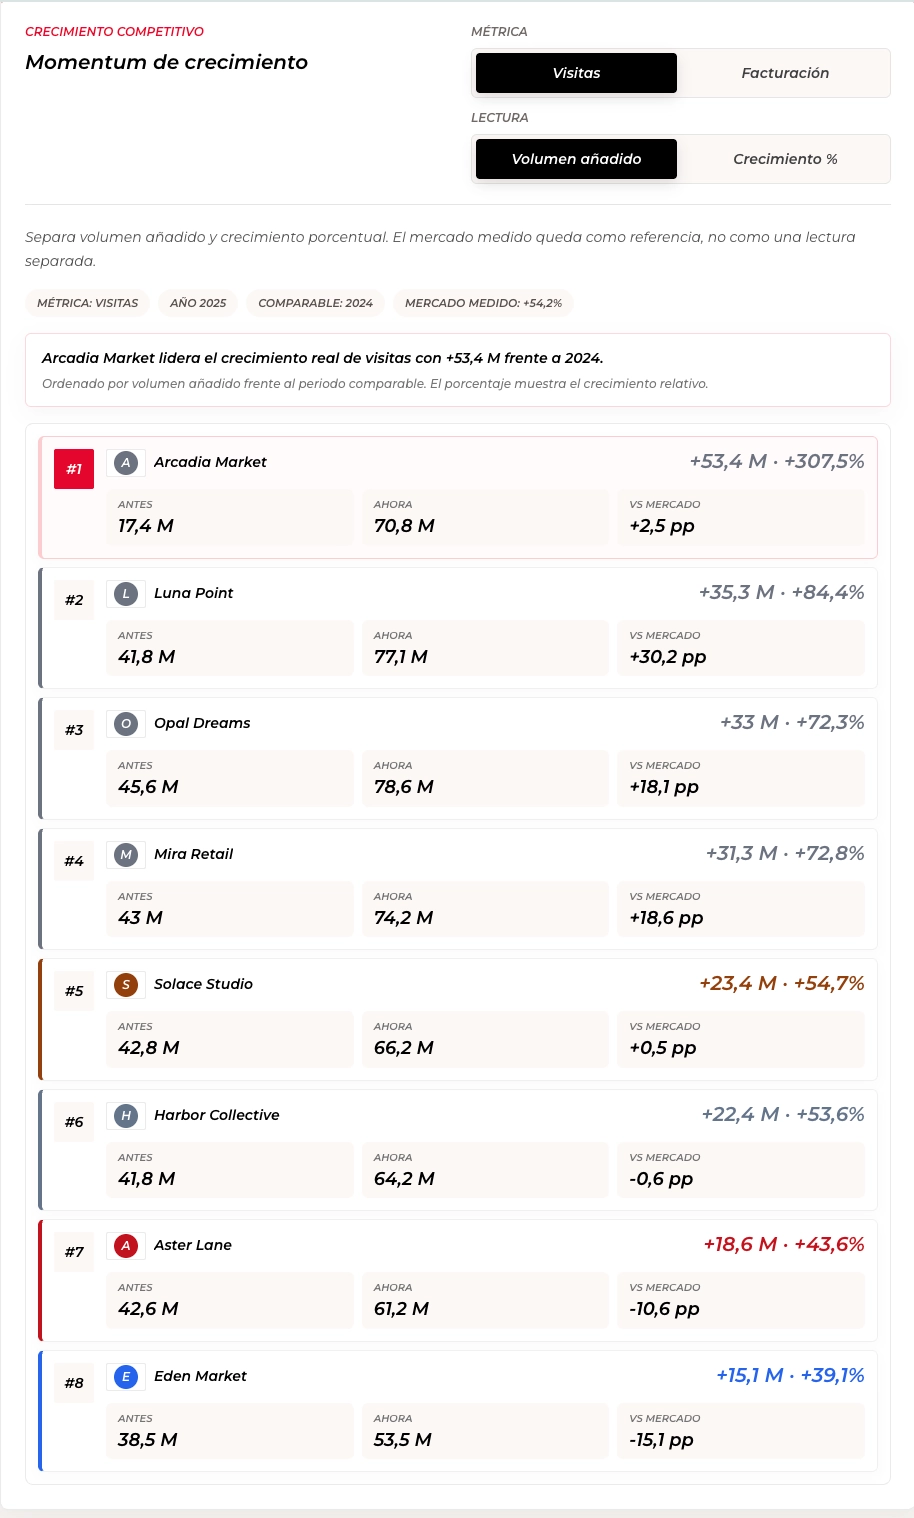
El crecimiento indexado y los cambios YoY/MoM se generan desde observaciones mensuales raw, no como valores finales guardados en el dashboard.
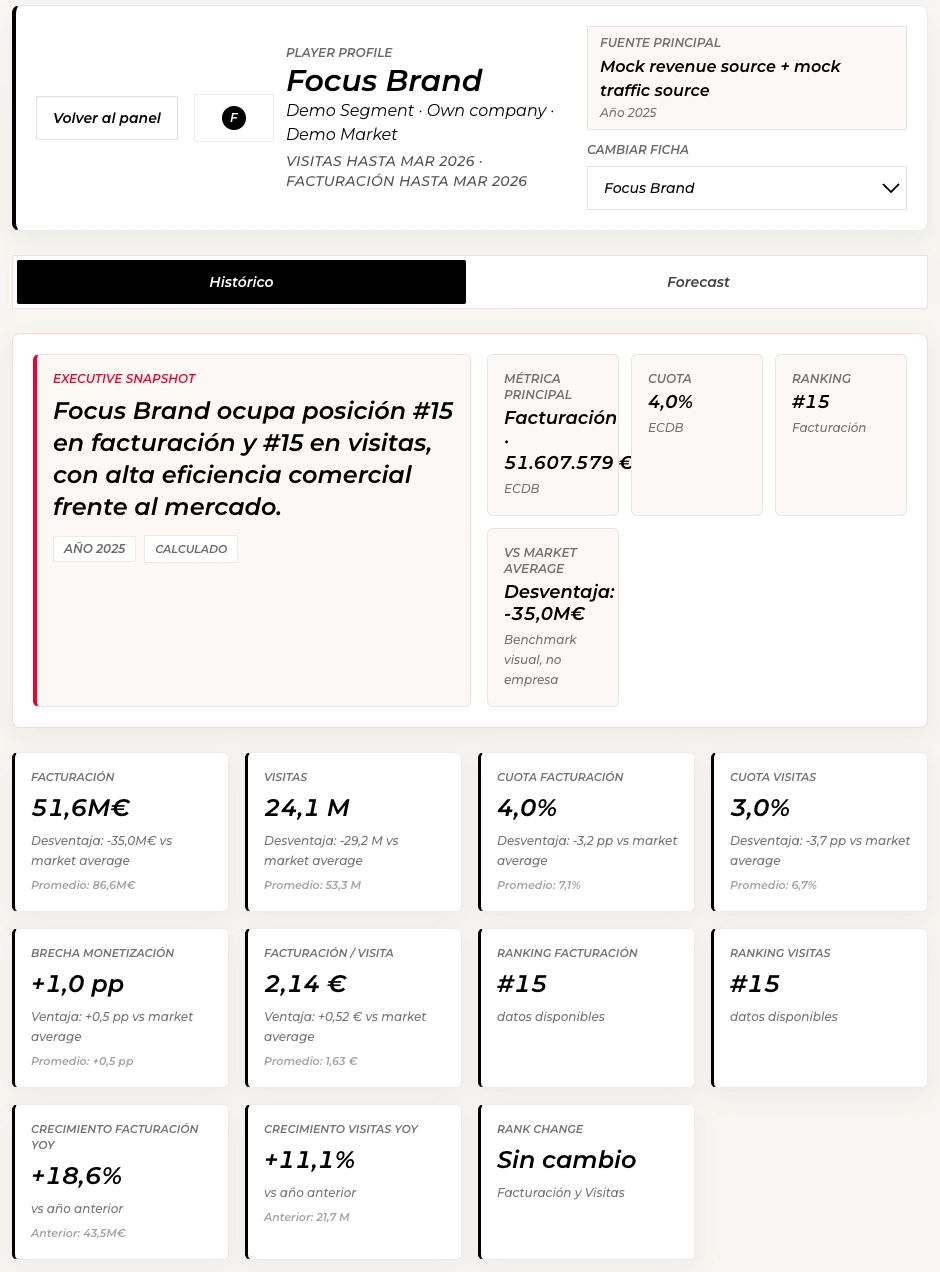
Perfil de compañía con métricas históricas y forecast generadas, disponible vía #/company/:id y rutas legacy #/empresa/:id.
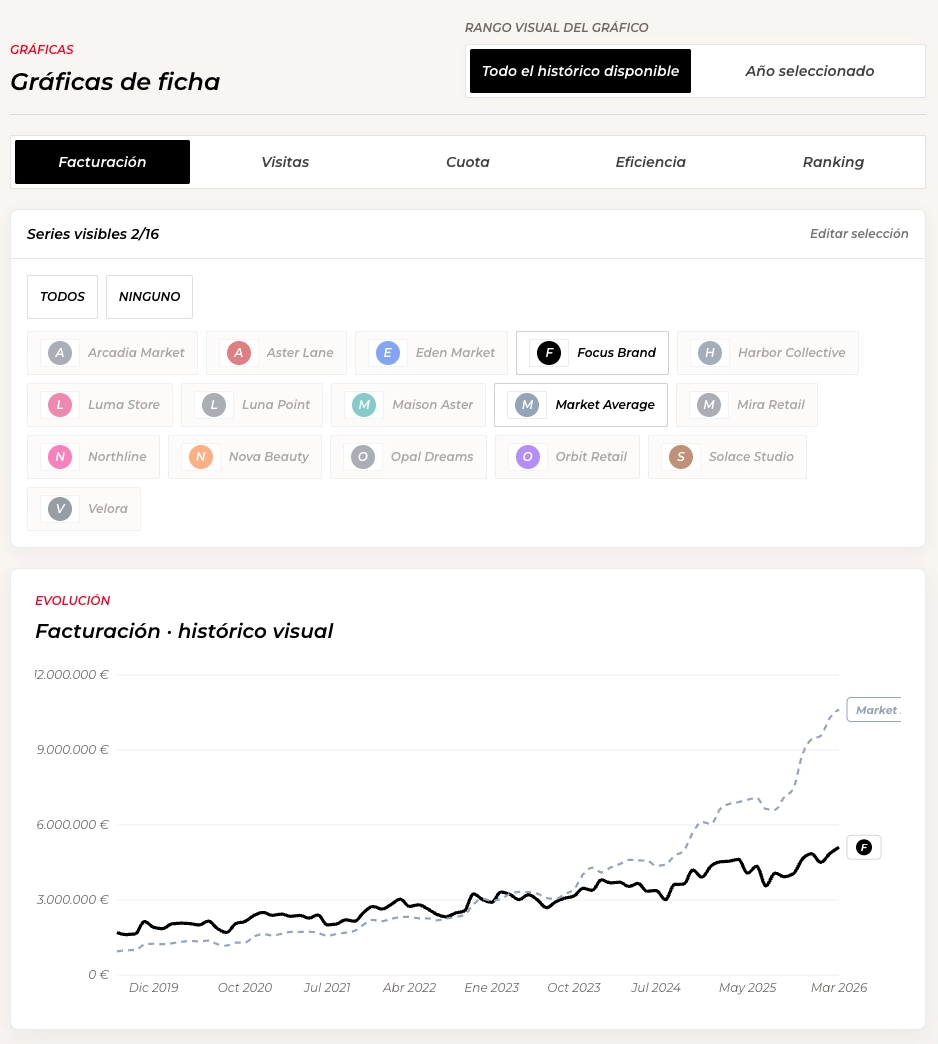
El gráfico enfocado compara una entidad con market_average generado o con pares seleccionados en métricas benchmark históricas.
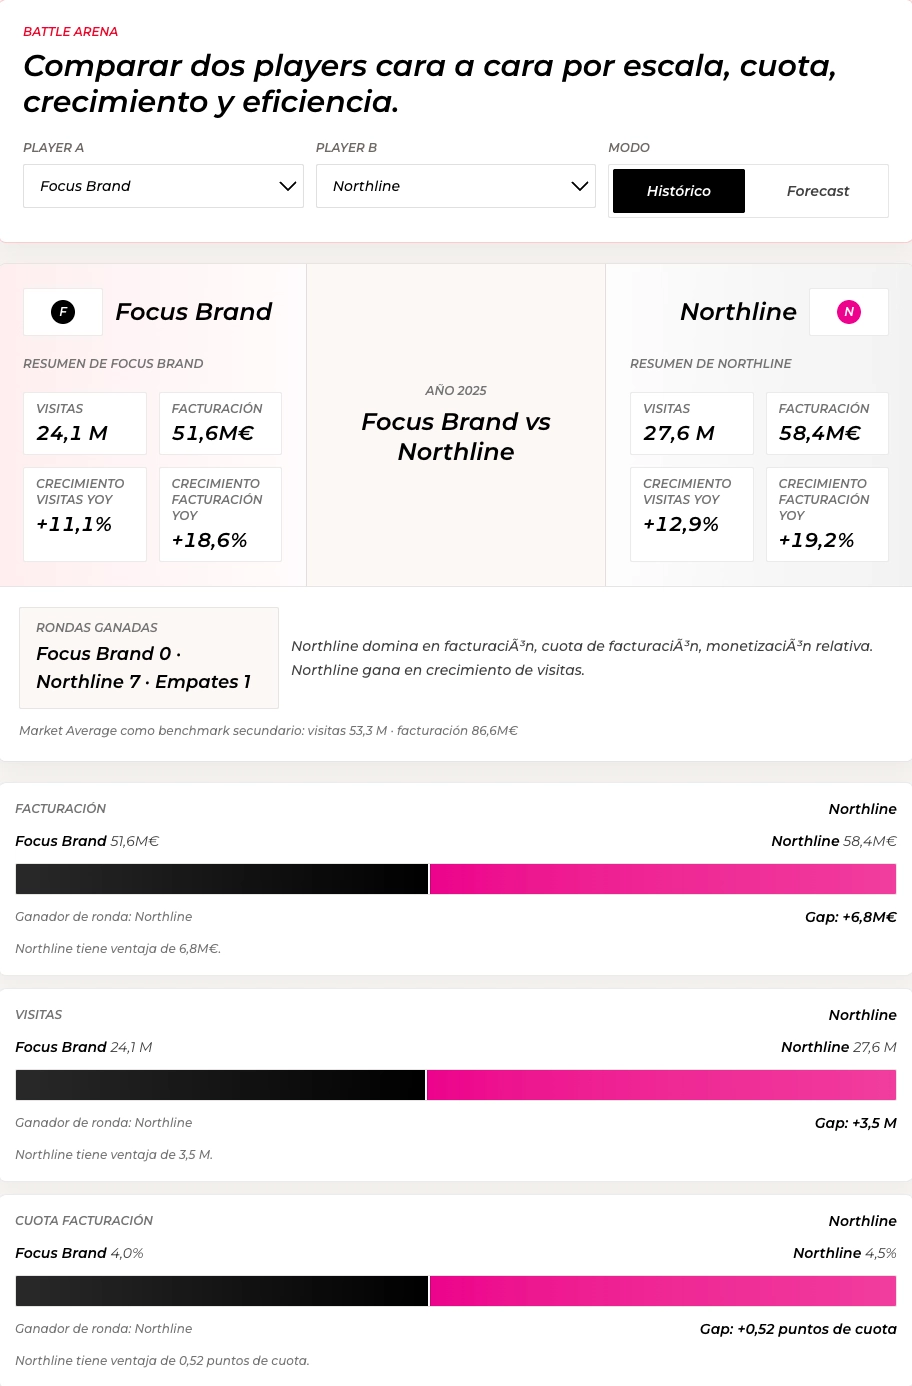
Battle Arena compara dos players sintéticos con métricas generadas de escala, cuota, crecimiento y eficiencia.
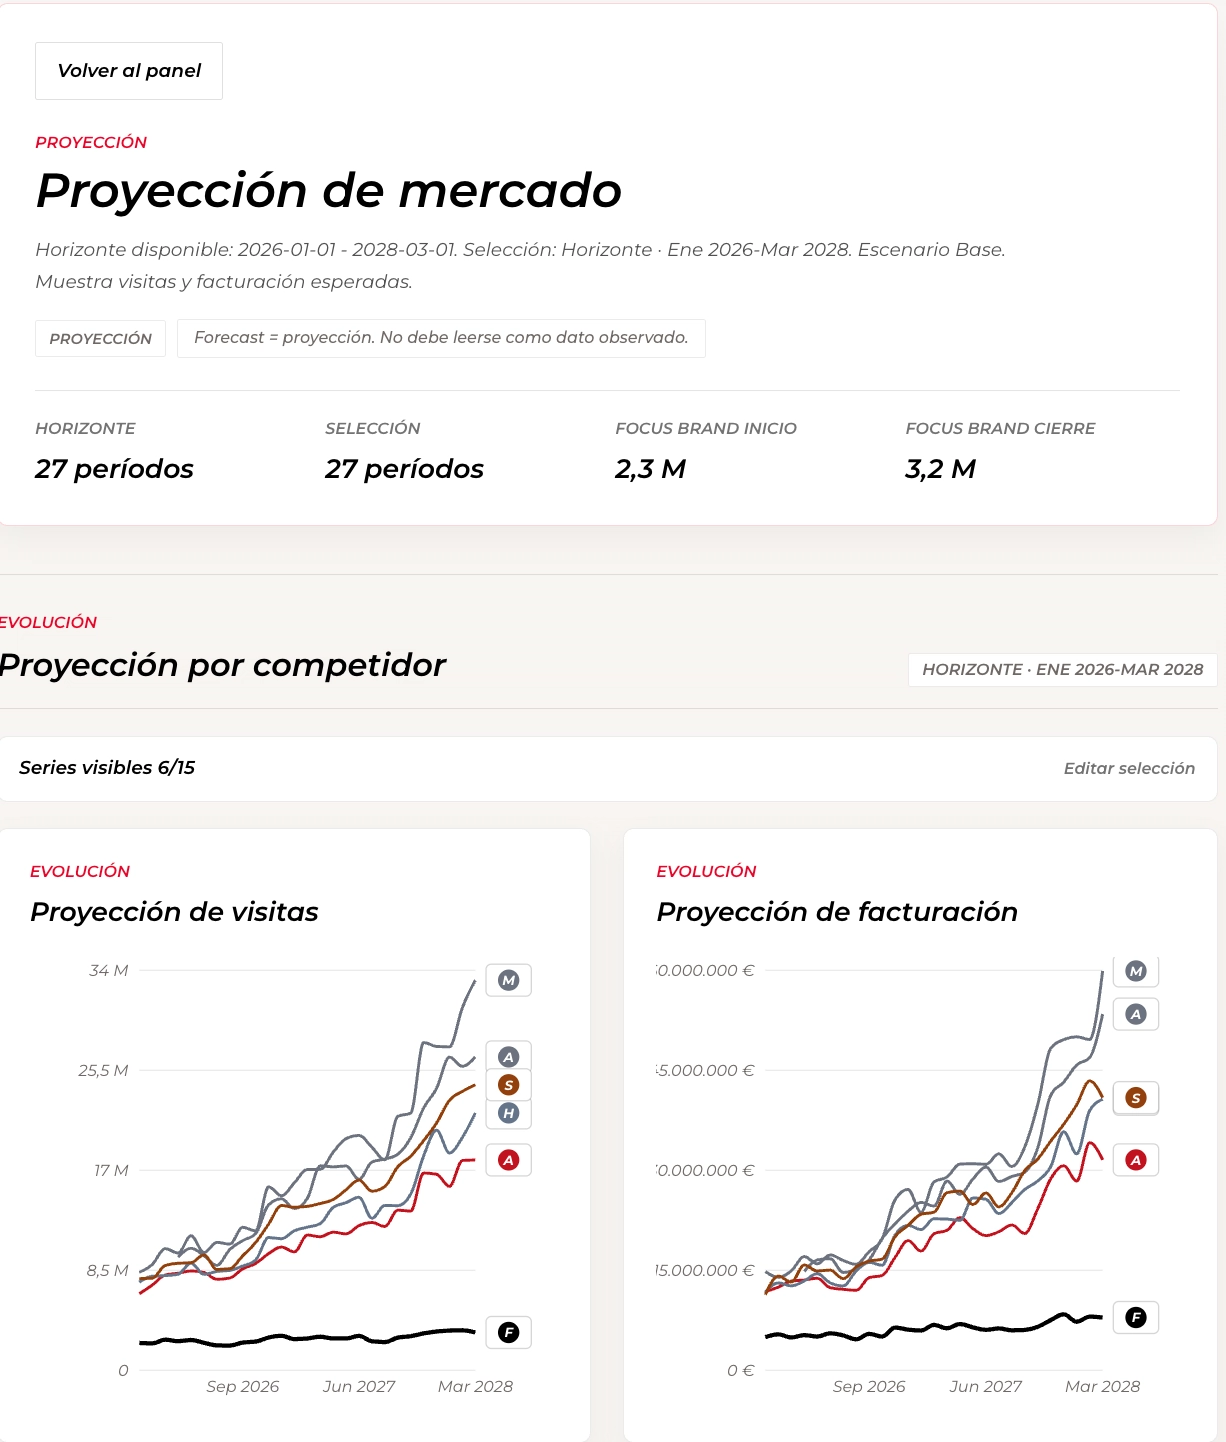
Vista de forecast con proyecciones locales de escenario que empiezan después de 2025-12-01 y recalculan filas benchmark por escenario.
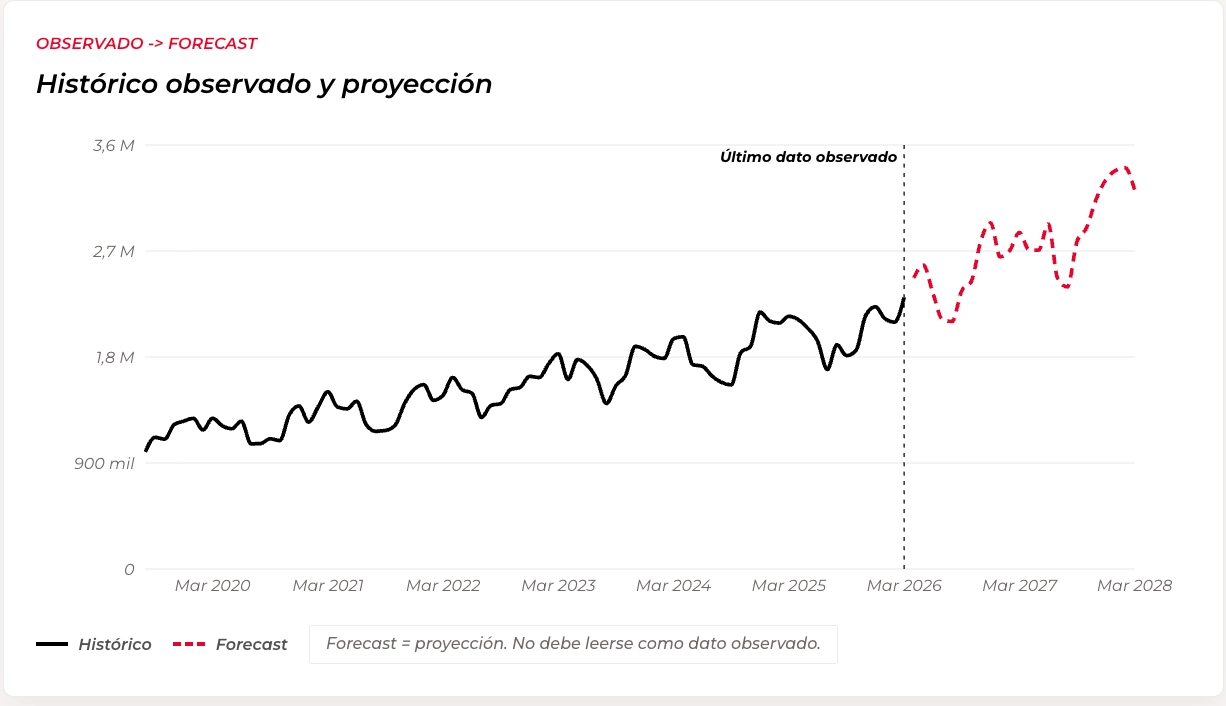
base_case, conservative y aggressive incluyen diagnósticos de confianza y se presentan como proyecciones de escenario.
Contrato de datos
El JSON guarda solo observaciones mensuales raw. La app genera las filas de interface internamente: forecast rows, market_total, market_average, cuota, rankings, métricas indexadas, crecimiento, revenue per visit y monetization gap se generan en código.
{
  "ok": true,
  "meta": {
    "dataset_name": "Demo Benchmark Dataset",
    "currency": "EUR",
    "source_type": "raw_monthly_observations",
    "data_policy": "Synthetic demo data only. No real company or client data is included."
  },
  "data": {
    "source_monthly": [
      {
        "date": "2025-01-01",
        "company_id": "focus",
        "display_name": "Focus Brand",
        "market": "Demo Market",
        "type": "own",
        "revenue": 125000,
        "visits": 82000,
        "active": true
      }
    ]
  }
}source_monthlygenerated rowsgenerated metricsDisciplina de publicación
El repo está diseñado para inspección pública. Usa nombres y valores sintéticos, cero datos privados de clientes, cero credenciales, ningún backend obligatorio, ninguna dependencia de API de pago, scripts de validación, auditoría pública, notas de seguridad, documentación de despliegue y un generador determinista de datos demo.
pnpm generate:datapnpm testpnpm buildpnpm validate:datapnpm audit:publicpnpm typecheckpnpm lintResultado
El resultado es un motor repetible de inteligencia benchmark que empieza con observaciones sintéticas raw y produce la capa analítica necesaria para vistas ejecutivas de cuota, ranking, monetización, agregación y escenarios.
Por qué importa
La inteligencia competitiva gana valor cuando la lógica de análisis es repetible. Este proyecto convierte observaciones mensuales raw en un pipeline benchmark inspeccionable en vez de tratar el dashboard como todo el producto.
Uso para clientes
Una versión para cliente podría ayudar a equipos de marca, ecommerce, marketing o estrategia a comparar mercados, monitorizar posicionamiento, diagnosticar gaps de monetización y producir lecturas ejecutivas sin rehacer el análisis desde cero.
Hablar de un sistema similar
Si tu equipo tiene un proceso creativo, herramienta interna, flujo de campaña o sistema de marca que merece ampliarse con IA, envía un brief breve y te ayudo a definir la lógica más clara.